Kafka Exchange Rates
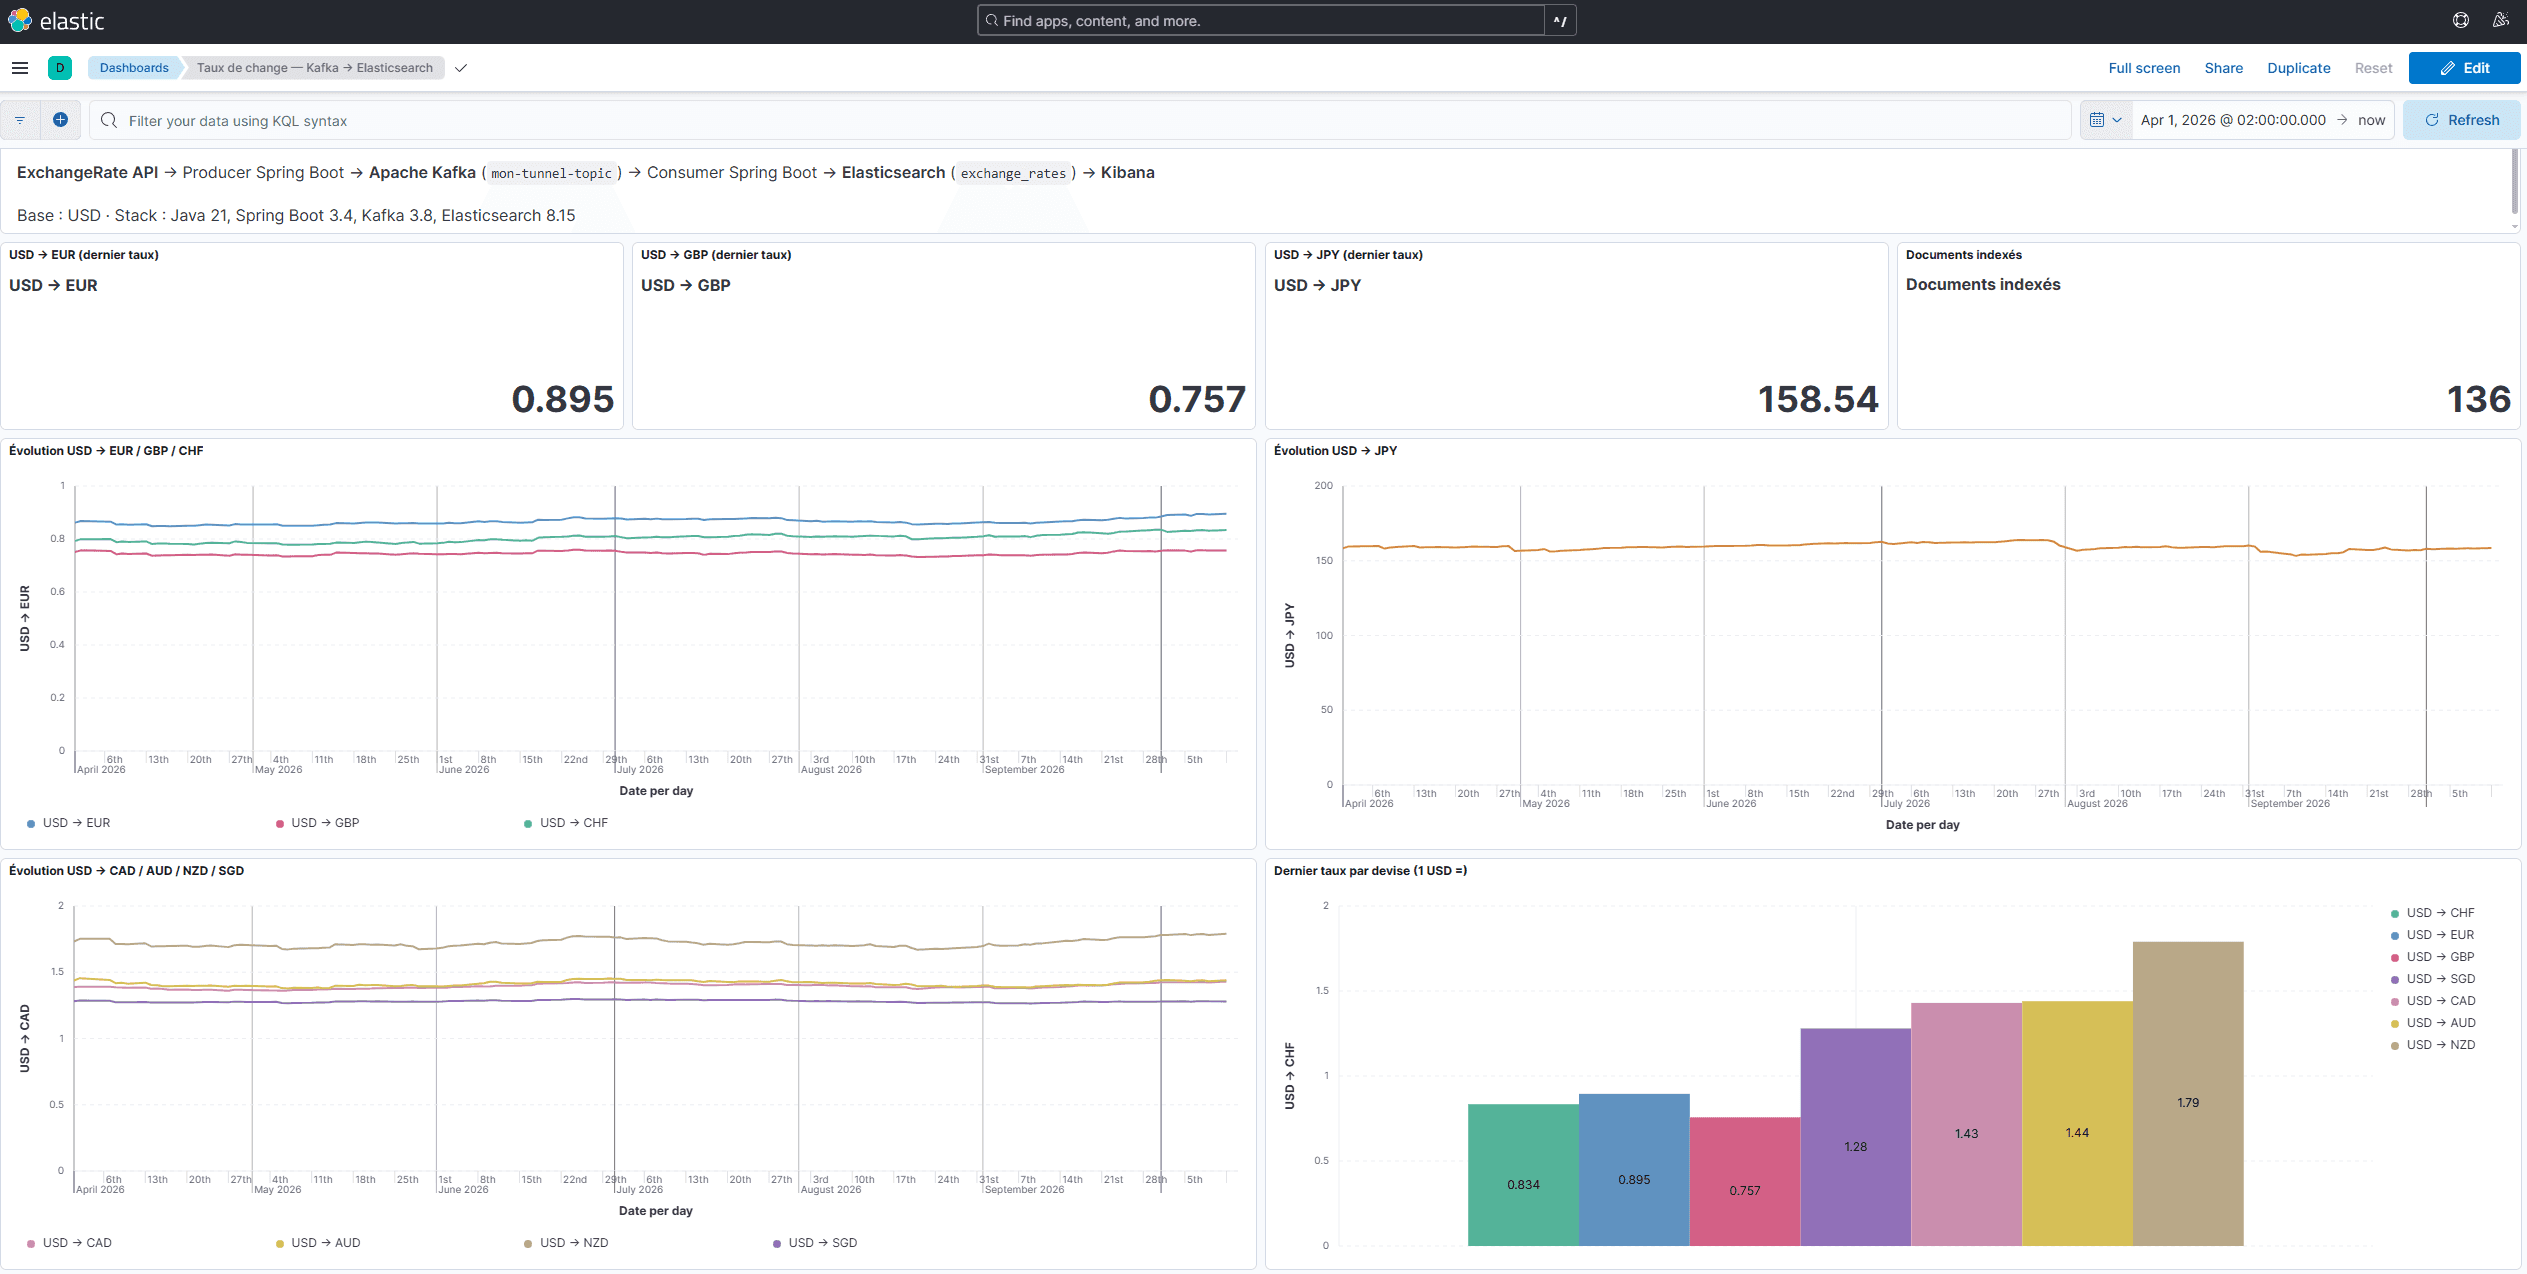
Pipeline événementiel qui ingère les taux de change d'une API publique, les fait transiter par Kafka et les indexe dans Elasticsearch, avec une API REST de consultation.
- Rôle
- Ingestion externe et indexation Elasticsearch
- Période
- février 2025 — juin 2025
- Statut
- Archivé
Stack·5
Le projet
Exercice en binôme autour du traitement de flux. Un producteur Spring Boot interroge une API publique de taux de change et pousse le résultat dans un topic Kafka ; un consommateur le reprend et l'indexe dans Elasticsearch, qui devient la source de consultation.
L'intérêt n'est pas le volume de code — il est modeste — mais le découplage : le producteur ignore qui consomme, et on peut brancher un second consommateur sans toucher au premier. C'est le seul projet de ce portfolio qui repose sur une architecture événementielle plutôt que sur un appel direct.
Mon périmètre
Mon binôme avait posé le squelette Spring Boot et l'aller-retour Kafka de base. J'ai ajouté toute la moitié aval : la récupération des taux auprès de l'API externe au démarrage de l'application, la création automatique de l'index Elasticsearch et de son mapping, la réécriture du consommateur pour qu'il indexe au lieu de simplement journaliser, et un contrôleur REST pour interroger les données indexées. Deux cent quatre-vingt-une lignes ajoutées sur les quatre cents que compte le code métier.
Un choix à connaître
Elasticsearch est attaqué directement par son API HTTP : aucun client dédié dans les dépendances, les requêtes sont construites à la main. Le protocole reste visible, au prix de la commodité qu'apporterait une bibliothèque.
La pile
Java 23, Spring Boot 3.4, Spring Kafka, Maven. Lombok pour les modèles, Actuator pour l'état de l'application.